Vous souvenez-vous du mystérieux modèle d’édition d’images AI « nano-banana » qui a fait couler tant d’encre ? À l’époque, dans l’arène des grands modèles de langage LMArena, il avait suscité de vifs débats grâce à ses performances remarquables. Les experts techniques de Google Gemini se sont succédé sur les réseaux sociaux, attisant la curiosité de tous, au point même d’être un temps considéré comme le légendaire Gemini 3.0 Pro.
Aujourd’hui, Google a enfin levé le voile sur ce mystère.
Le 27 août à l’aube (UTC+8), Google AI Studio a officiellement lancé Gemini 2.5 Flash Image (nom de code nano banana) 🍌.
Après une longue attente, Gemini 2.5 Flash Image fait enfin son apparition | Source : GeekPark
Il s’agit à ce jour du modèle de génération et d’édition d’images le plus avancé de Google. Non seulement il est d’une rapidité fulgurante, offrant une expérience quasi « éclair », mais il a aussi décroché des résultats SOTA sur de nombreux classements, dominant largement sur LMArena.
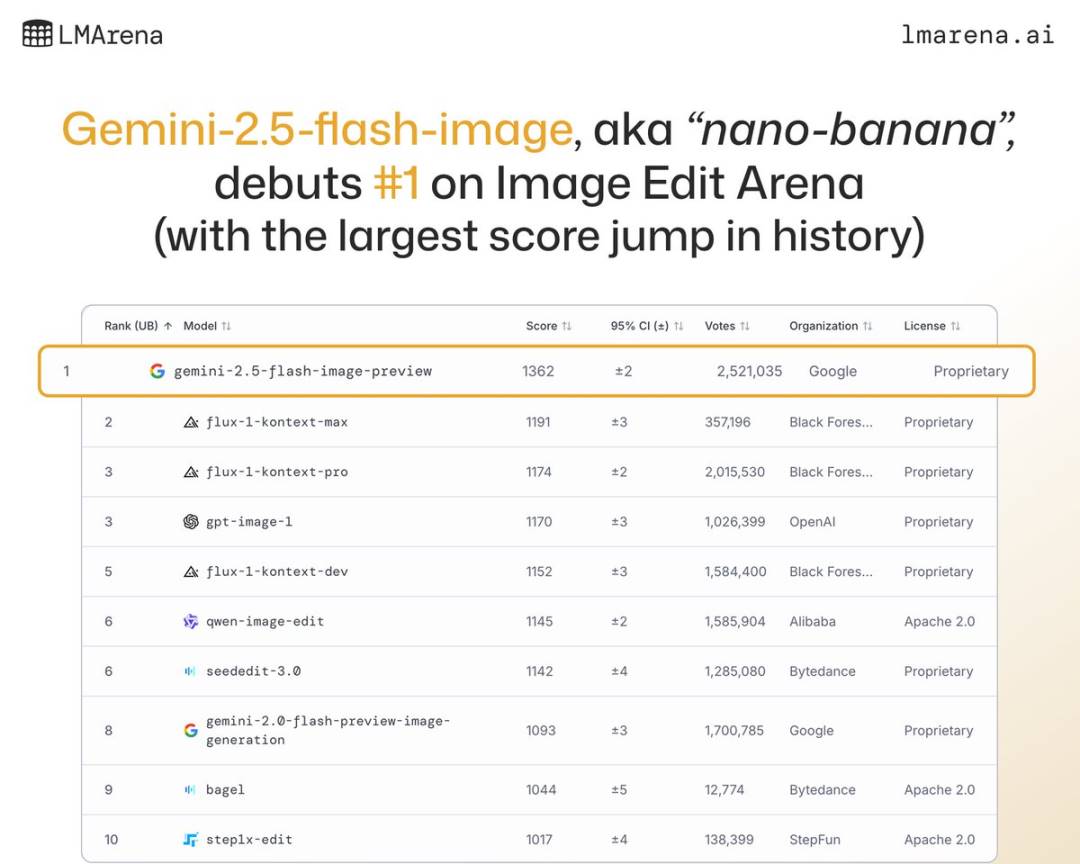
Dès son lancement, Gemini 2.5 Flash Image atteint des capacités SOTA | Source : LMarena.ai
Dans son blog technique, Google explique que Gemini 2.0 Flash avait déjà séduit les développeurs grâce à sa faible latence et son excellent rapport qualité-prix, mais les utilisateurs attendaient des images de meilleure qualité et un contrôle créatif plus puissant. Gemini 2.5 Flash Image arrive donc avec ces améliorations majeures : la cohérence des personnages est enfin pleinement préservée, l’édition d’images basée sur des prompts est plus précise, la fusion de plusieurs images est naturelle et fluide, et la compréhension du monde réel est renforcée, faisant de ce modèle non seulement un outil, mais aussi le « point de départ » pour la prochaine génération d’applications à succès.
GeekPark a également pu le tester dès sa sortie. À la surprise générale, il ne s’agit pas seulement d’une mise à jour de modèle, mais d’une première expérience tangible de ce à quoi pourrait ressembler l’avenir de la retouche photo par l’IA.
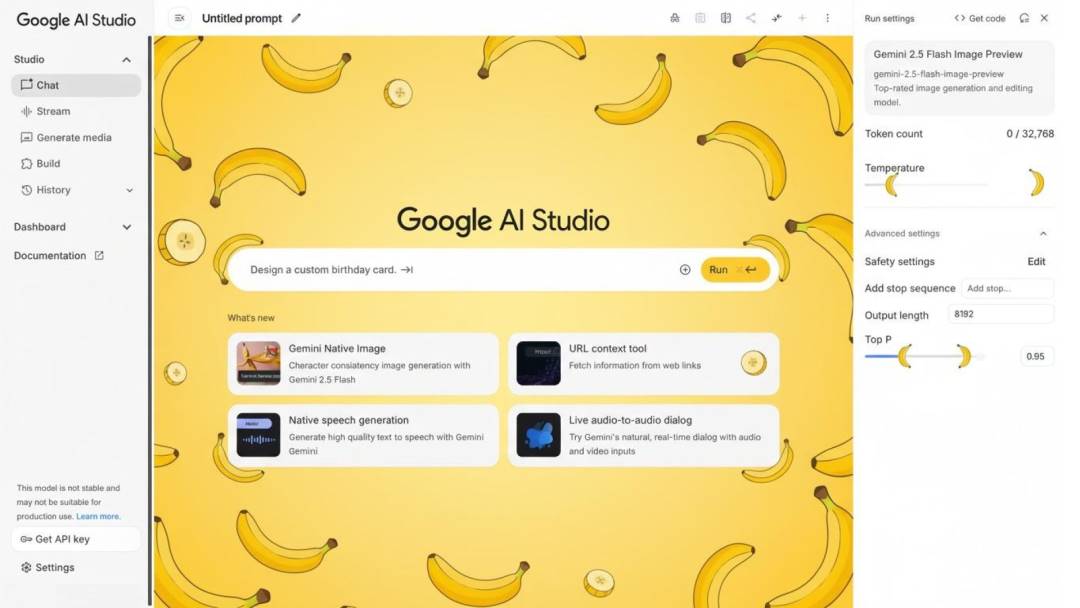
L’expérience est déjà accessible dans Google AI Studio | Source : GeekPark
Au début, je voulais simplement tester ce nouveau modèle pour voir « à quel point il est plus rapide ». Mais en quelques heures d’utilisation, j’ai eu l’impression d’entrevoir à l’avance le visage des futures applications à succès.
Jusqu’à présent, nous étions habitués à des outils comme Meitu XiuXiu : quelques clics, un filtre, et la photo devient plus belle. Mais Gemini 2.5 Flash Image offre une sensation totalement différente. Il est incroyablement rapide, intelligent comme un designer qui comprend vos envies : il suffit de décrire l’effet souhaité, et il le réalise en quelques secondes.
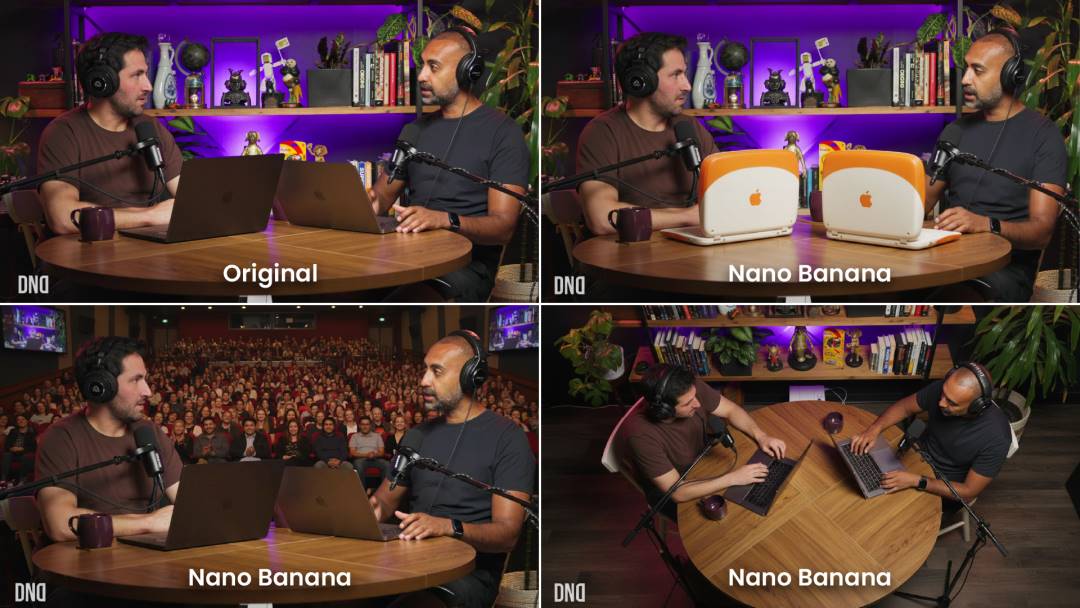
Outre la qualité, la vitesse distingue aussi Gemini 2.5 Flash Image des précédents produits de génération d’images | Source : GeekPark
01 Génération ultra-rapide, résultat en quelques secondes
L’aspect le plus frappant de l’expérience nano banana, c’est la vitesse. Avec les anciens modèles open source, même avec un ordinateur performant, il fallait attendre des dizaines de secondes, voire plus, entre le prompt et l’image générée. Pour les utilisateurs mobiles, cette attente était encore plus pénible.
Mais Gemini 2.5 Flash Image abaisse cette barrière à quelques secondes seulement. Il s’agit du modèle multimodal natif « le plus récent, le plus rapide et le plus efficace » selon Google, qui a clairement mis l’accent sur l’optimisation. Lors de mes tests, un simple prompt générait un résultat en trois ou quatre secondes (UTC+8), avec une résolution et des détails très nets.
Cela rappelle l’expérience de Meitu XiuXiu : un clic sur « embellir » et l’effet est quasi instantané. La différence, c’est que Meitu XiuXiu applique un filtre, tandis que Gemini 2.5 Flash Image construit une image à partir de zéro ou modifie profondément une photo selon vos besoins. Cette sensation de « viser et obtenir » est incomparable avec les processus fastidieux de retouche traditionnels.
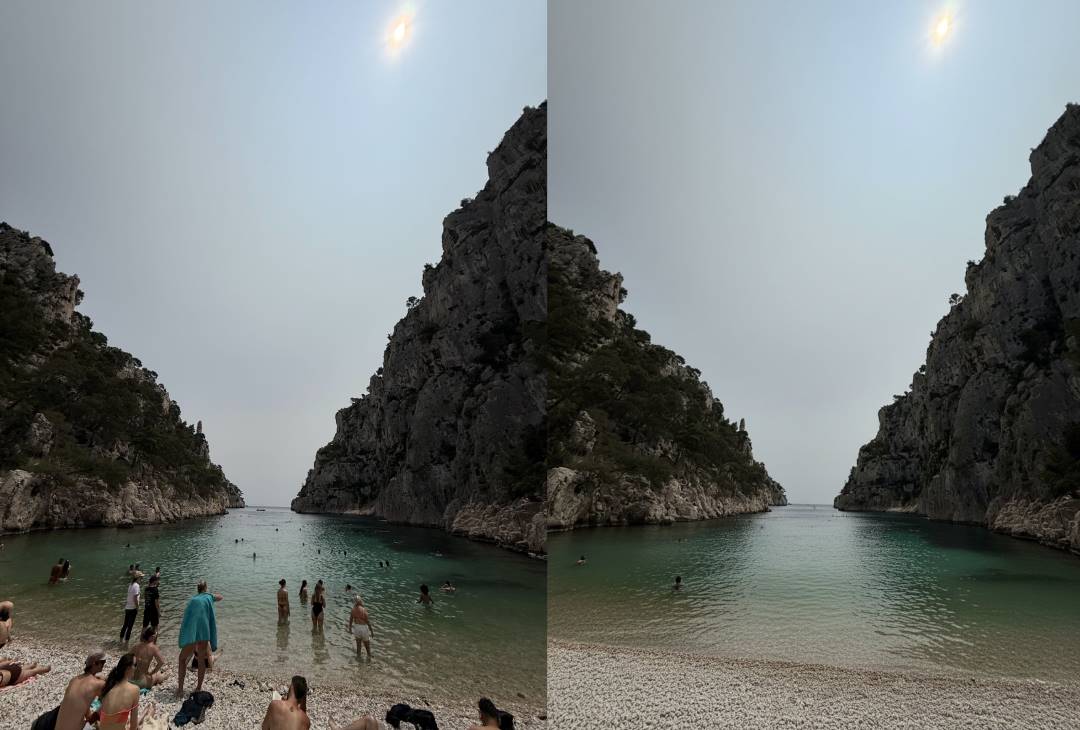
Pour des demandes comme « supprimer les passants en arrière-plan », un simple prompt suffit | Source : GeekPark
Si la vitesse améliore l’expérience utilisateur traditionnelle, le « multimodal natif » repousse les limites des capacités d’image de l’AI.
Gemini 2.5 Flash Image ne se contente pas de générer des images, il comprend aussi simultanément texte et image en entrée. Cela signifie que je peux lui fournir une photo et un prompt textuel, et il combinera les deux pour comprendre précisément ce que je veux.
Par exemple, j’ai téléchargé une photo de rue et demandé « change l’arrière-plan pour une scène nocturne à Shinjuku, Tokyo » (UTC+8). Il a non seulement identifié le sujet de la photo, mais aussi parfaitement détouré la personne et remplacé l’arrière-plan par les néons de Shinjuku. Plus impressionnant encore, il a conservé la cohérence des ombres et lumières, sans l’effet « collage grossier » souvent inévitable avec un détourage manuel.
Cette compréhension me rappelle une fonction souvent mise en avant ces dernières années dans les galeries photo des smartphones : le « changement d’arrière-plan en un clic ». Mais à l’époque, les bords étaient flous, les lumières incohérentes, le rendu peu naturel. Désormais, Gemini 2.5 Flash Image s’appuie sur la connaissance du monde et la compréhension visuelle pour peaufiner ces détails, offrant un résultat bien plus naturel et une fidélité des détails supérieure à celle des outils traditionnels de génération d’images à partir de texte ou d’image.
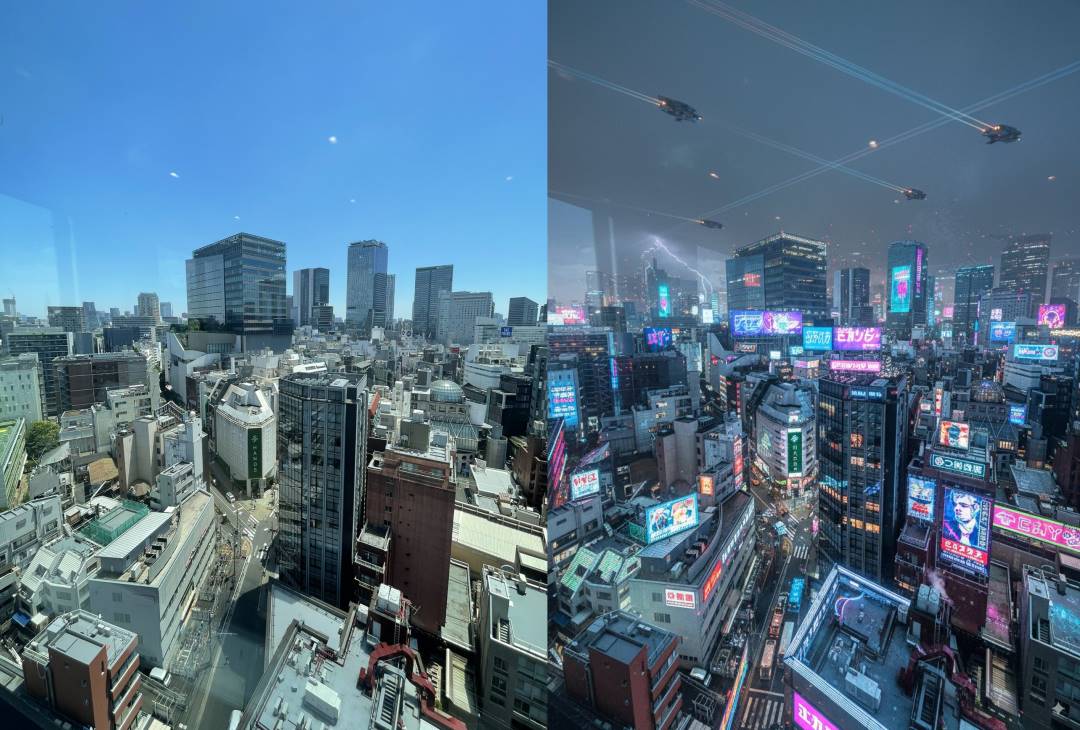
Image originale & résultat généré par Gemini 2.5 Flash Image | Source : GeekPark
C’est pourquoi je pense qu’il va redéfinir l’expérience de retouche : il ne s’agit plus de multiples ajustements manuels, mais d’une exécution « à la volée » grâce à la compréhension sémantique du modèle, notamment dans les scénarios exigeant une grande précision des détails, comme la retouche de portraits.
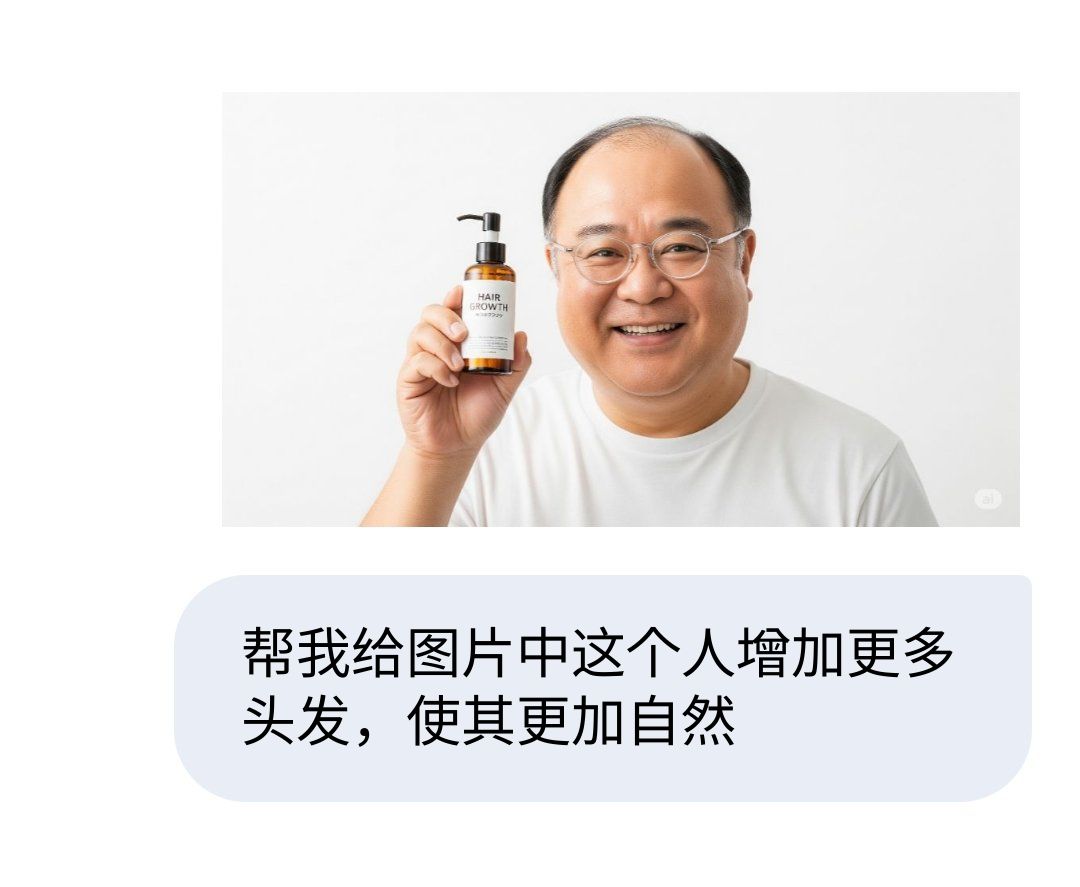
Pour ce type de traitement de portraits, la cohérence de rôle offerte par Gemini 2.5 Flash Image procure vraiment une expérience de « Vibe Photoshoping » inédite.
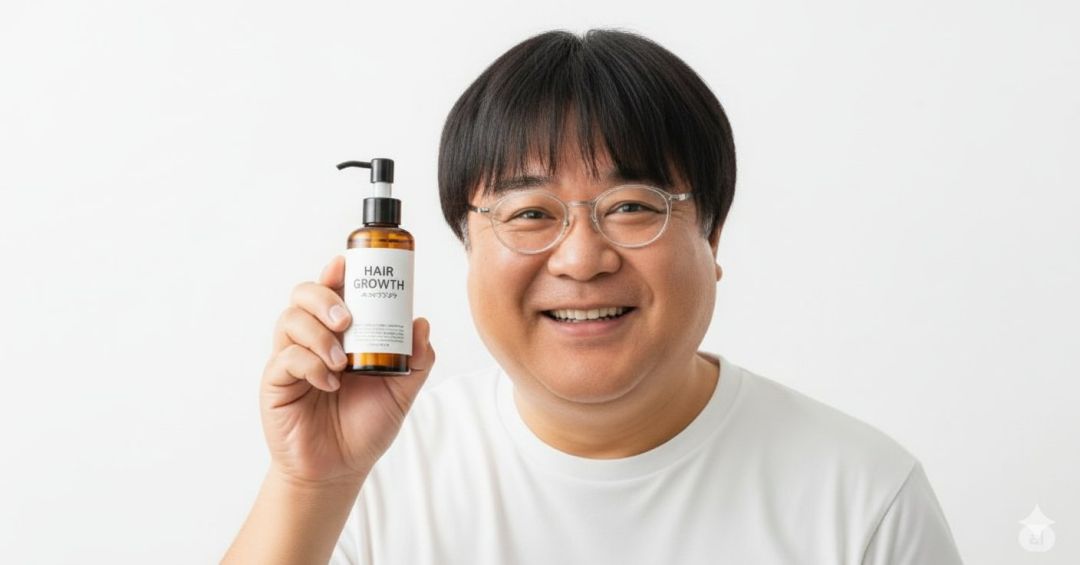
En une seconde, il redonne confiance au programmeur | Source : GeekPark
Cette expérience bouleverse l’image que beaucoup avaient de la génération d’images par AI — « ésotérique » : un prompt bien rédigé donne un résultat bluffant ; un prompt moyen, et le résultat peut être totalement à côté de la plaque.
Mais avec Gemini 2.5 Flash Image, j’ai constaté que cette « part de hasard » est bien moindre. Sa compréhension des prompts est plus précise et plus intuitive pour l’utilisateur — c’est pourquoi beaucoup le trouvent soudainement bien plus pratique.
Par exemple, je lui demande « floute l’arrière-plan, mets en valeur le sujet » (UTC+8), et en quelques secondes, le résultat correspond exactement à mes attentes ; je lui demande « remplace l’expression de la personne par un sourire », et non seulement la bouche s’étire, mais même le regard change, avec une grande finesse ; j’ai même essayé « colorise cette photo en noir et blanc », et le résultat n’est pas un coloriage aléatoire, mais s’approche au maximum de l’ambiance colorée des photos historiques.
Cette capacité à « faire ce qu’on dit » me rappelle l’époque où, sur Meitu XiuXiu, je voulais juste lisser la peau, mais toute la photo devenait un visage artificiel ultra-lissé. Désormais, Gemini 2.5 Flash Image agit avec précision et retenue : il comprend vraiment ce que vous voulez, puis s’efforce de le restituer fidèlement.
02 Des capacités renforcées, difficile de revenir en arrière
Pour être plus concret, j’ai comparé Gemini 2.5 Flash Image avec les outils de retouche mobile que j’utilise au quotidien.
Sur Snapseed, pour flouter l’arrière-plan, il faut généralement une à deux minutes pour sélectionner manuellement la zone de premier plan, puis ajuster le flou. Même avec de l’expérience, il faut souvent corriger plusieurs fois.
Sur Meitu XiuXiu, la fonction de flou d’arrière-plan en un clic existe, mais elle floute souvent aussi les bords du sujet, rendant le résultat peu naturel.
Avec Gemini 2.5 Flash Image, une simple phrase suffit : il détecte automatiquement les frontières entre le sujet et l’arrière-plan, le flou est naturel, sans retouche supplémentaire.
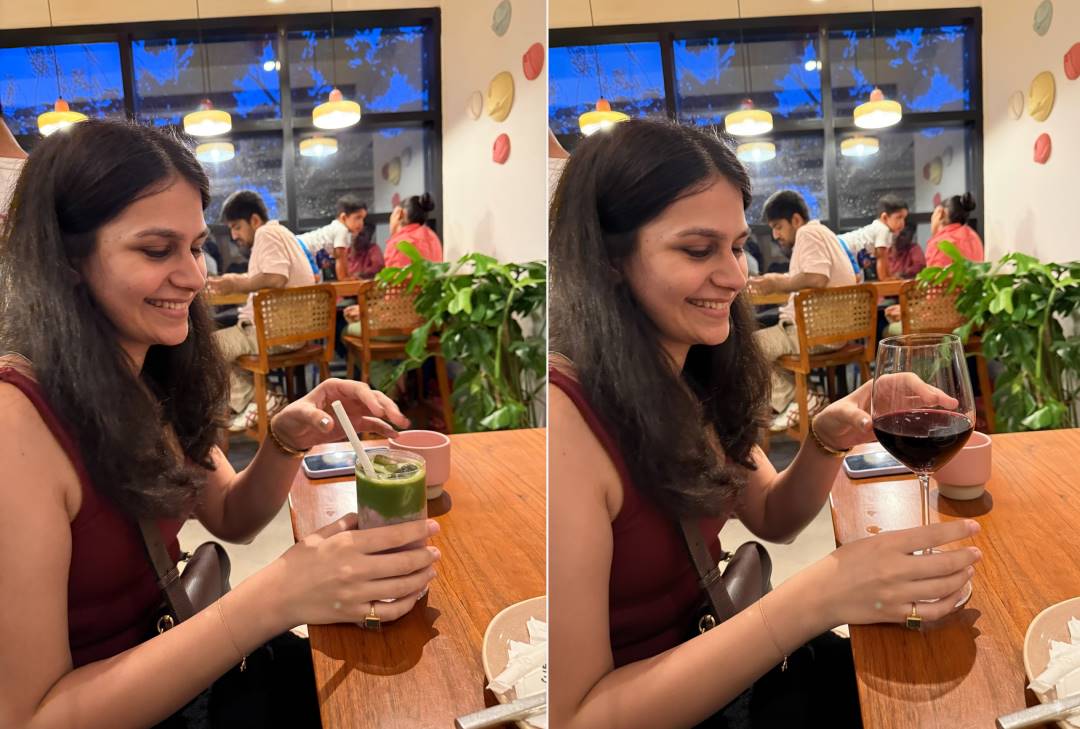
En modifiant les détails de l’image, il évite aussi les « gribouillages » fréquents des anciens outils AI | Source : Twitter
Cette comparaison montre une chose : Gemini 2.5 Flash Image libère l’utilisateur des opérations complexes, confiant davantage de tâches au modèle. Pour le grand public, il abaisse le seuil de la retouche ; pour les professionnels, il fait gagner un temps précieux.
Après l’avoir testé, mon impression principale est que Gemini 2.5 Flash Image n’est plus seulement un outil de retouche, mais s’apparente davantage à un « assistant intelligent ».
Avant, avec Meitu XiuXiu, on utilisait une collection de fonctions prédéfinies : filtres, embellissement, mosaïque, chaque bouton correspondait à une fonction. Il fallait choisir, ajuster, jusqu’à satisfaction.
Aujourd’hui, la logique de Gemini 2.5 Flash Image est complètement différente. Il ne vous demande plus d’apprendre à utiliser l’outil, il comprend directement vos besoins. Il suffit de les exprimer, il s’en charge.
Ce changement, en apparence subtil, bouleverse en réalité tout le processus de retouche. Avant, c’était à nous de nous adapter à l’outil, maintenant c’est l’outil qui s’adapte à nous. Cette interaction préfigure la prochaine génération d’applications.
Pour l’instant, Gemini 2.5 Flash Image en est encore à ses débuts, avec des limites fonctionnelles. Mais sa vitesse, sa compréhension et sa fidélité laissent entrevoir un avenir prometteur.
Et si on l’intégrait à Meitu XiuXiu ? Peut-être qu’on ouvrirait l’application, dirait « améliore cette photo, rends la peau plus naturelle », et le résultat apparaîtrait en quelques secondes (UTC+8) ; ou bien, en voyage, on demanderait « change le temps en ensoleillé » (UTC+8), et la photo deviendrait instantanément lumineuse ; ou même, en montage vidéo, une phrase suffirait à changer l’ambiance d’un clip.
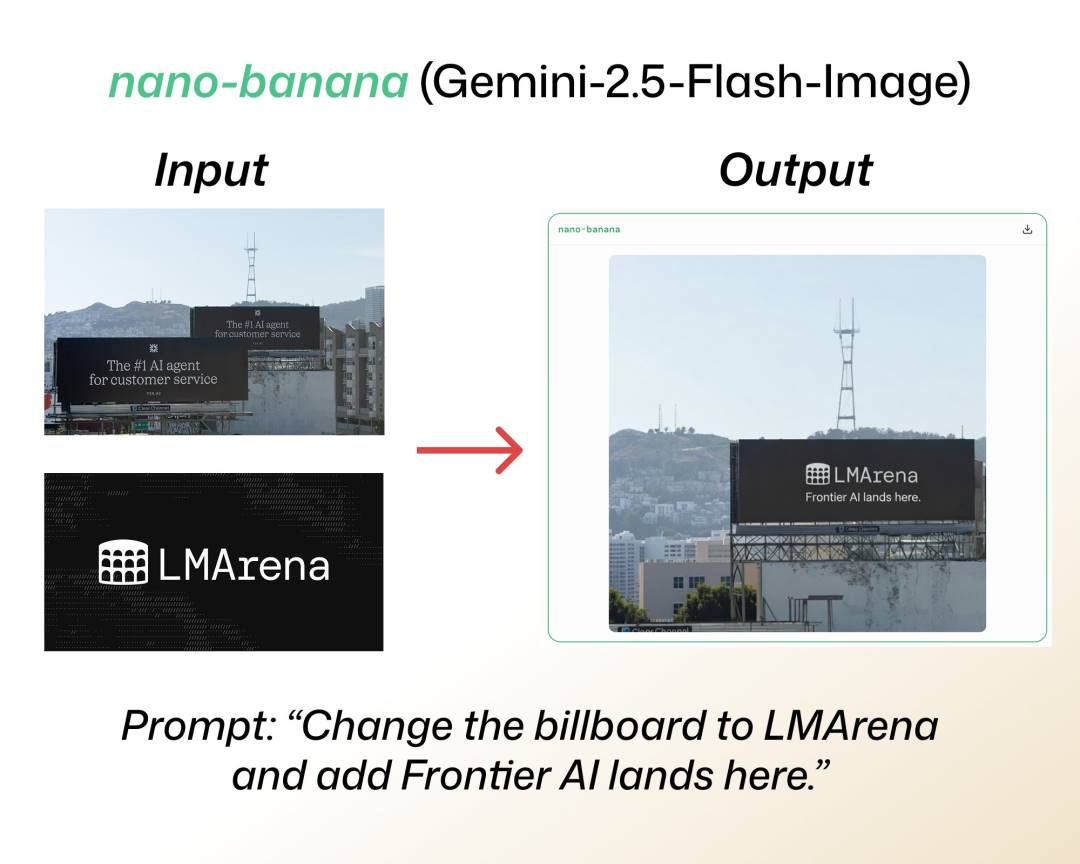
Ce mode pourrait rapidement devenir la fonction d’édition d’images principale des systèmes d’exploitation mobiles | Source : Twitter
C’est pourquoi je pense qu’il va révolutionner rapidement les processus actuels des outils de retouche, et définir la prochaine génération de « Meitu XiuXiu » : il ne s’agit plus seulement de retoucher, mais de réinventer l’interaction avec le traitement d’image, faisant de l’AI votre partenaire de post-production photo.
Mais pour l’instant, Gemini 2.5 Flash Image ne peut pas encore servir d’application de retouche grand public prête à l’emploi : non seulement parce que son objectif principal reste la génération d’images plutôt que l’ajustement sur une base existante, mais aussi parce que toutes les images créées ou éditées via Gemini 2.5 Flash Image comportent un filigrane numérique SynthID, permettant aux plateformes sociales d’identifier les contenus générés par AI.
03 Le point de départ d’un futur best-seller
En y repensant, si Meitu XiuXiu est devenu une application universelle, c’est parce qu’il a résolu de la façon la plus simple un problème que tout le monde voulait régler : rendre les photos plus belles.
Gemini 2.5 Flash Image va plus loin, transformant la puissance complexe de l’AI en une expérience de génération d’images « en une seconde » accessible à tous.
La première fois que je lui ai dit « floute l’arrière-plan » (UTC+8), et que le résultat naturel est apparu en quelques secondes, j’ai su : c’est le point de départ d’une application à succès. Ce n’est pas seulement un modèle, mais la capacité de base de nombreux futurs produits.
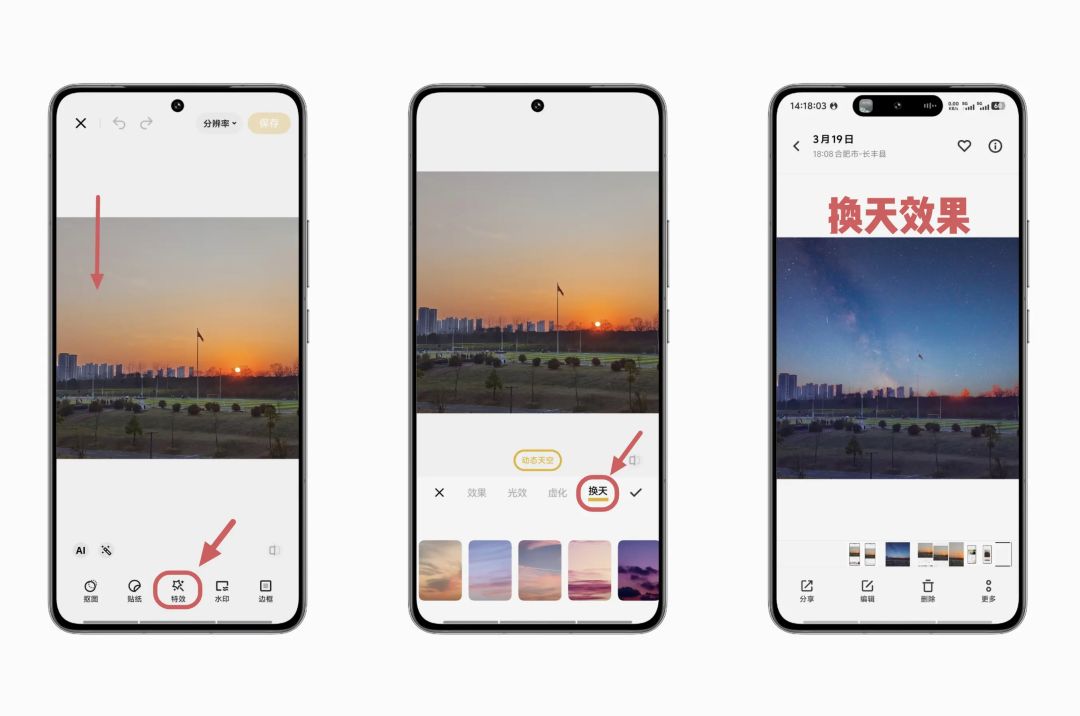
La fonction AI de changement de ciel en un clic qui a fait fureur chez les utilisateurs de smartphones ces dernières années | Source : communauté vivo
Peut-être qu’un jour, nous oublierons le nom de code Banana, mais nous verrons de plus en plus d’outils de traitement d’images qui permettent de « dire ce que l’on veut et l’obtenir instantanément », et qui, comme Meitu XiuXiu à son époque, deviendront un souvenir commun d’une génération d’utilisateurs.
Mais cette fois, l’AI poussera l’imagination encore plus loin.